发布时间:2026-06-24 14:45:02
Python爬虫说白了就是一套自动化的数据抓取工具。它借助代码模拟浏览器的操作行为,自动访问网页并从中抽取结构化的数据内容。
不过,出于安全防护、资源保护以及商业利益等方面的考量,各大网站通常会布设反爬虫策略,用于识别并拦截自动化的访问请求。
IP代理技术的关键在于在爬虫程序与目标站点之间架设一层中转节点,从而改变请求的实际传输路径:
在这套架构下,目标网站只能看到代理服务器的IP地址,根本无法追溯到爬虫的真实IP。
借助多个代理IP交替发送请求,可以把单一IP的高频访问特征,分散为多个IP的常规访问行为,进而绕过反爬虫的检测机制。
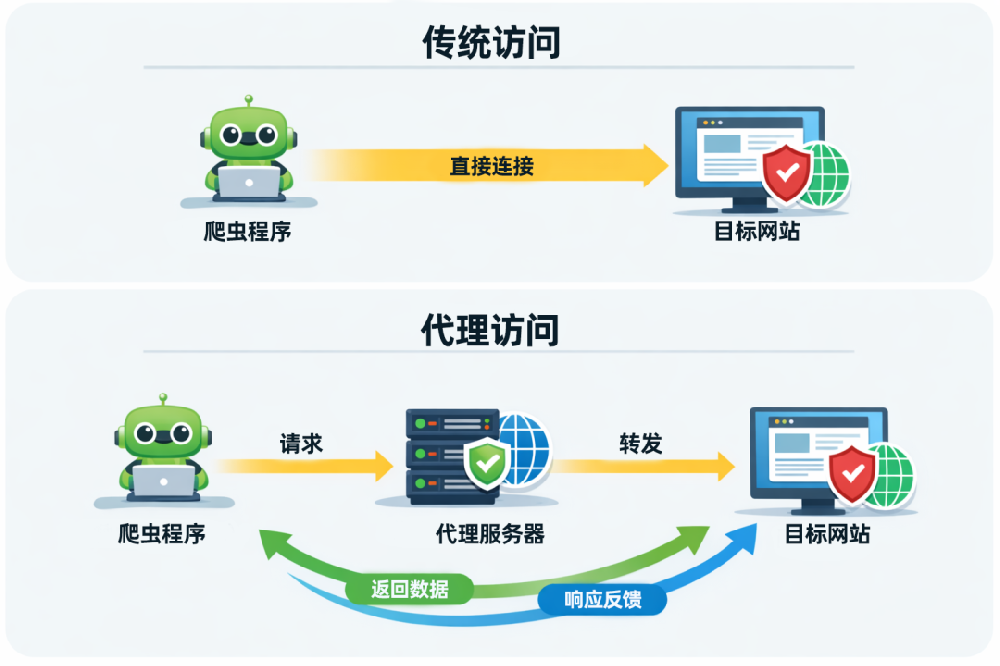
在Python爬虫开发中,请求默认走的是当前网络环境下的本机IP出口。
当访问频率上升或抓取页面数量增加时,同一IP发出的大量请求很容易触发网站的访问限制。通过在发起请求时指定代理IP,就能让请求不再直接从本机发出,而是经由代理服务器进行中转。
从实现角度来看,requests、urllib等主流HTTP库均已内置代理配置支持,接入门槛非常低
在线客服
您好,需要客服帮助吗?